【2026年最新】データ分析の公式はこれだけ!実務で役立つ重要数式を徹底解説
生成AIツールが定着した2026年現在、あらゆるダッシュボードに自動集計された数字が並び、ワンクリックで美しいグラフが生成される時代を迎えました。しかし、現場の最前線で多くのビジネスパーソンが直面しているのは、「ツールが弾き出した数字の根拠を役員に問われ、説明に窮する」「施策の因果関係が説明できず予算獲得を見送られる」という致命的な壁です。
「データ分析の公式」と聞くと、難解な記号が並ぶ学術書を連想して拒絶反応を示す方も少なくありません。しかし、現場の意思決定で本当に求められる基本数式は、実は驚くほど一握りに限られています。表面的なツールの操作スキルから脱却し、意思決定の拠り所となる数式の構造を整理しておくことが、2026年のビジネスシーンで成果を分ける決定打となっています。
📌 【この記事の重要ポイントまとめ】
- 要点1:実務で成果を出すために暗記すべきデータ分析の公式は「記述統計・相関回帰・仮説検定」の3領域・計8個に集約される。
- 要点2:エクセルの分析関数と数式のメカニズムを両輪で理解することで、AIが出力する数値のハルシネーションや解釈ミスを瞬時に見抜ける。
- 要点3:公式の計算自体はツールに委ねつつ、「どの前提でどの数式を適用すべきか」という判断の境界線を見極めるリテラシーが2026年の必須スキルとなる。
【結論】データ分析の公式に悩む必要はない|現場で結果を出す必須数式の一握り
データ分析の公式に悩んでいませんか?実は最低限押さえるべき重要数式は一握りです。膨大な統計理論の海に飛び込み、偏微分や線形代数の証明問題に時間を奪われる必要はまったくありません。実務におけるビジネスデータ分析入門の観点では、「数式を白紙から手計算できること」ではなく、「その数式が入力データをどう変換し、何を意味する値を導いているのか」を言語化できるかどうかが本質です。
実務現場で求められる数式は、大きく分けて次の3つの階層に分類されます。第1階層は集団の全体像を要約する「代表値とばらつき(平均値・標準偏差)」、第2階層は変数同士の連動性を捉えて予測に繋げる「相関・単回帰分析」、そして第3階層はサンプルの偶然を排除して真偽を確かめる「仮説検定・分散分析」です。この3つの柱を押さえるだけで、売上要因の特定からマーケティング施策のABテスト検証、新商品の需要予測まで、ビジネス課題の約8割に対処可能です。
公式の役割は、混沌とした現場の事象から「ノイズ(偶然のブレ)」を削ぎ落とし、「シグナル(本質的な傾向)」を抽出するレンズに他なりません。数式の導出プロセスに立ち止まるのではなく、意思決定のツールとして使いこなす視点が不可欠です。
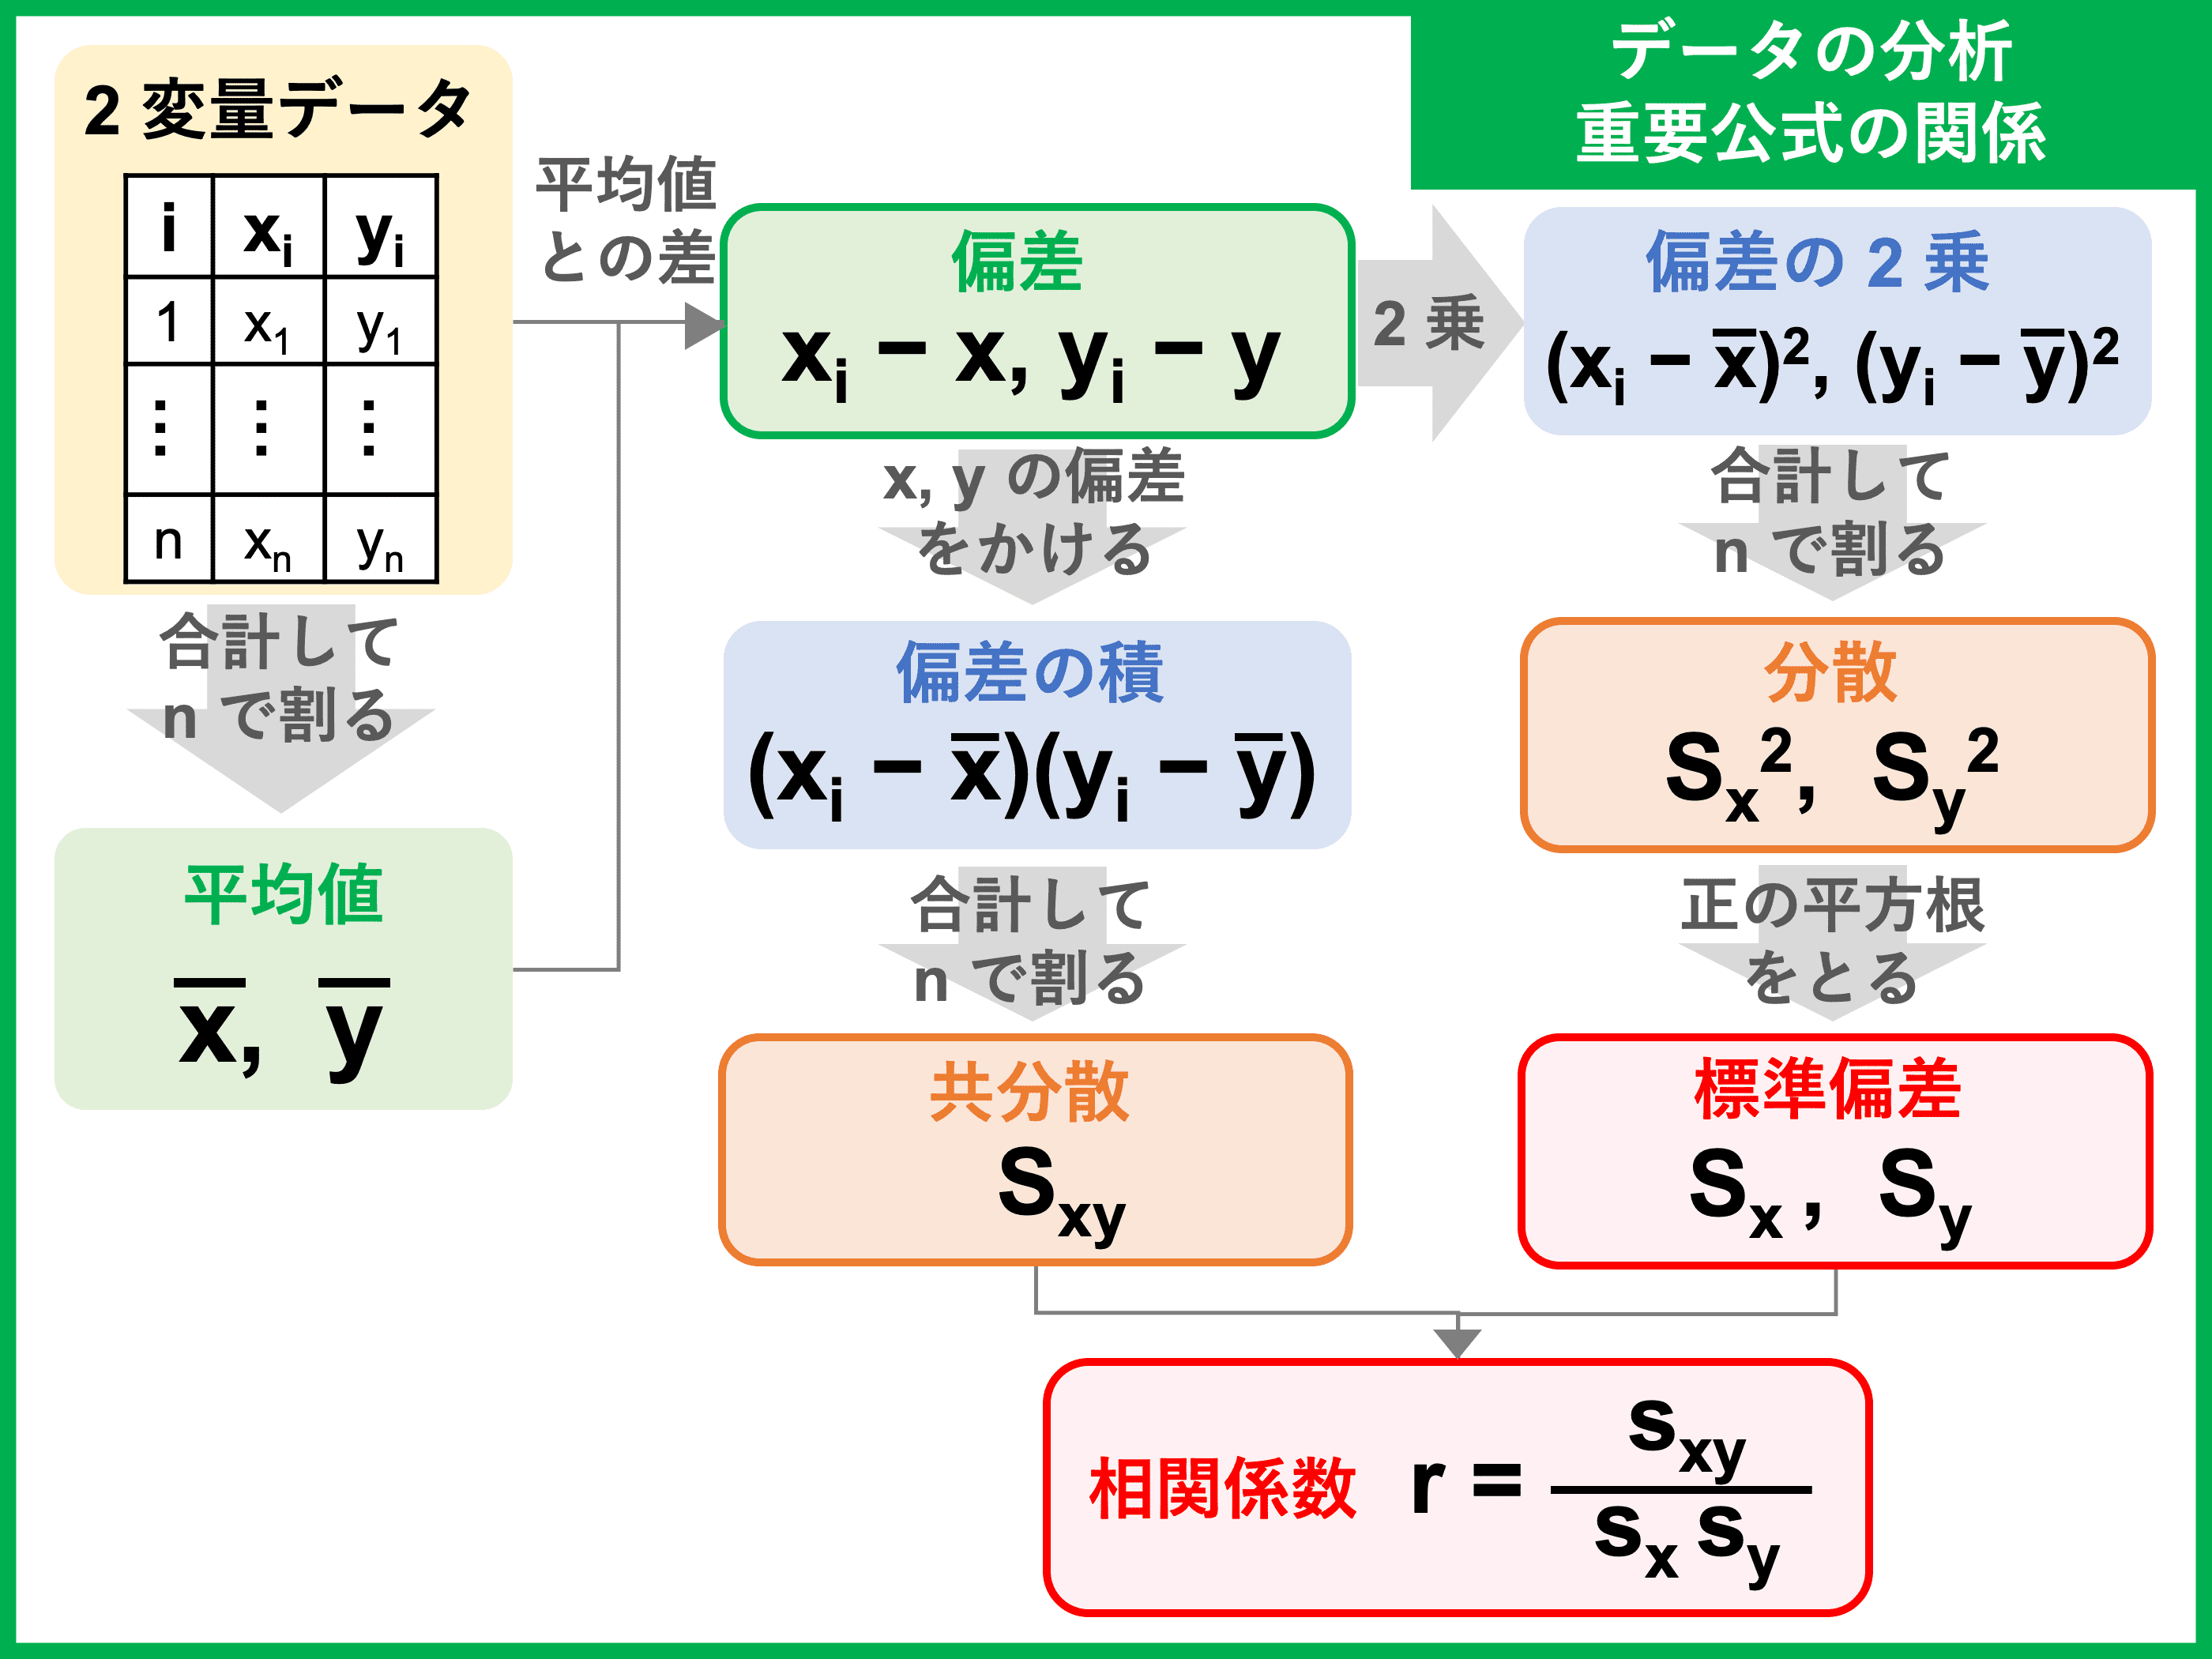
基礎から実務直結まで!データサイエンティスト必須数式と統計学公式一覧
現場で日常的に使用される統計学公式一覧の中から、特に頻出するコアな数式とその設計思想を解き明かします。いずれもデータサイエンティスト必須数式として基礎研修で叩き込まれる重要項目です。
1. データの重心を見極める:平均値中央値最頻値使い分け
データを代表する1つの数値を決定する際、多くの人が無意識に平均値(算術平均)を用います。しかし、ここには実務上の大きな落とし穴が存在します。
・平均値(Mean): $\bar{x} = \frac{1}{n}\sum_{i=1}^n x_i$
全データを足してデータ数で割る最も一般的な指標。正規分布に近いデータには最適ですが、極端な外れ値に弱く、一部の富裕層や超高額取引によって数値全体が実態から大きく乖離します。
・中央値(Median): データを昇順に並べた際、ちょうど中央に位置する値。
外れ値の影響を一切受けないため、年収データ、顧客生涯価値(LTV)、滞在時間などのロングテールな分布を把握する際に必須となります。
・最頻値(Mode): 最も出現頻度が高い値。
アパレルの売れ筋サイズや靴のサイズ、アンケートの満足度評価など、離散的なカテゴリーの代表値を捉える際に機能します。
2. リスクとブレを可視化する:標準偏差計算公式
ビジネスにおいて「平均」と同じ、あるいはそれ以上に重要なのが「データのばらつき」です。それを定量化するのが標準偏差計算公式です。
標本分散: $s^2 = \frac{1}{n-1}\sum_{i=1}^n (x_i - \bar{x})^2$
標本標準偏差: $s = \sqrt{s^2} = \sqrt{\frac{1}{n-1}\sum_{i=1}^n (x_i - \bar{x})^2}$
各データから平均値を引いた「偏差」を二乗して合計し、自由度(n-1)で割って平方根を取ります。なぜ二乗するのかといえば、プラスとマイナスの偏差が相殺されてゼロになるのを防ぎ、かつ大きなブレに対してペナルティを与えるためです。標準偏差($\sigma$や$s$)を把握することで、「平均売上100万円・標準偏差10万円の安定店舗」と「平均売上100万円・標準偏差80万円のハイリスク店舗」を明確に峻別できるようになります。
3. 変数間の連動性を測る:相関係数求め方
2つの要素に関連があるかを探る指標が、ピアソンの積率相関係数です。相関係数求め方の基本式は、共分散をそれぞれの標準偏差の積で割る構造になっています。
相関係数: $r = \frac{s_{xy}}{s_x s_y} = \frac{\sum (x_i - \bar{x})(y_i - \bar{y})}{\sqrt{\sum (x_i - \bar{x})^2} \sqrt{\sum (y_i - \bar{y})^2}}$
値は必ず-1から+1の間に収まります。+1に近ければ「一方が増えればもう一方も増える(正の相関)」、-1に近ければ「一方が増えればもう一方は減る(負の相関)」、0付近は無相関を示します。広告費と獲得件数、Webサイトのスクロール深度と購買率など、施策の当たりをつける初動フェーズで多用されます。
4. 未来の数値を予測する:単回帰分析計算式
相関関係から一歩進み、「原因(説明変数 $x$)」から「結果(目的変数 $y$)」を予測する直線モデルを導くのが単回帰分析です。直線の式は $y = ax + b$ で表されますが、この傾き $a$ と切片 $b$ を求める単回帰分析計算式は最小二乗法によって次のように定義されます。
傾き: $a = \frac{s_{xy}}{s_x^2} = \frac{\sum (x_i - \bar{x})(y_i - \bar{y})}{\sum (x_i - \bar{x})^2}$
切片: $b = \bar{y} - a\bar{x}$
実績値と予測直線とのズレ(残差)の二乗和を最小化する計算式です。これにより、「広告出稿量を100万円増やしたとき、売上は何万円伸びるか」という限界効果を定量的にシミュレーション可能になります。
5. 偶然か必然かを判定する:仮説検定手順と分散分析計算手順
Webマーケティングの施策検証などで「バナーAとバナーBでCVRに差が出たが、これは単なる偶然のブレか、それとも施策の真の効果か」をジャッジするのが仮説検定手順です。
- 仮説の設定: 差がないとする「帰無仮説($H_0$)」と、差があるとする「対立仮説($H_1$)」を立てる。
- 有意水準の決定: 慣例として5%($\alpha = 0.05$)または1%に設定する。
- 検定統計量の算出: t検定の場合、サンプルサイズと標準誤差からt値を計算する。
- p値の判定: 算出されたp値が0.05を下回れば帰無仮説を棄却し、「統計的に有意な差がある」と結論づける。
また、3群以上の平均値の差を比較する場合、t検定を繰り返すと第一種の過誤(偽陽性)が跳ね上がるため、分散分析計算手順(ANOVA)を用います。「全体のばらつき」を「グループ間のばらつき(施策効果)」と「グループ内のばらつき(ノイズ)」に分解し、F比(群間平方和/群内平方和)を導き出して有意差を検定します。
【完全網羅】データ分析手法一覧と比較表|実務で使える公式チートシート
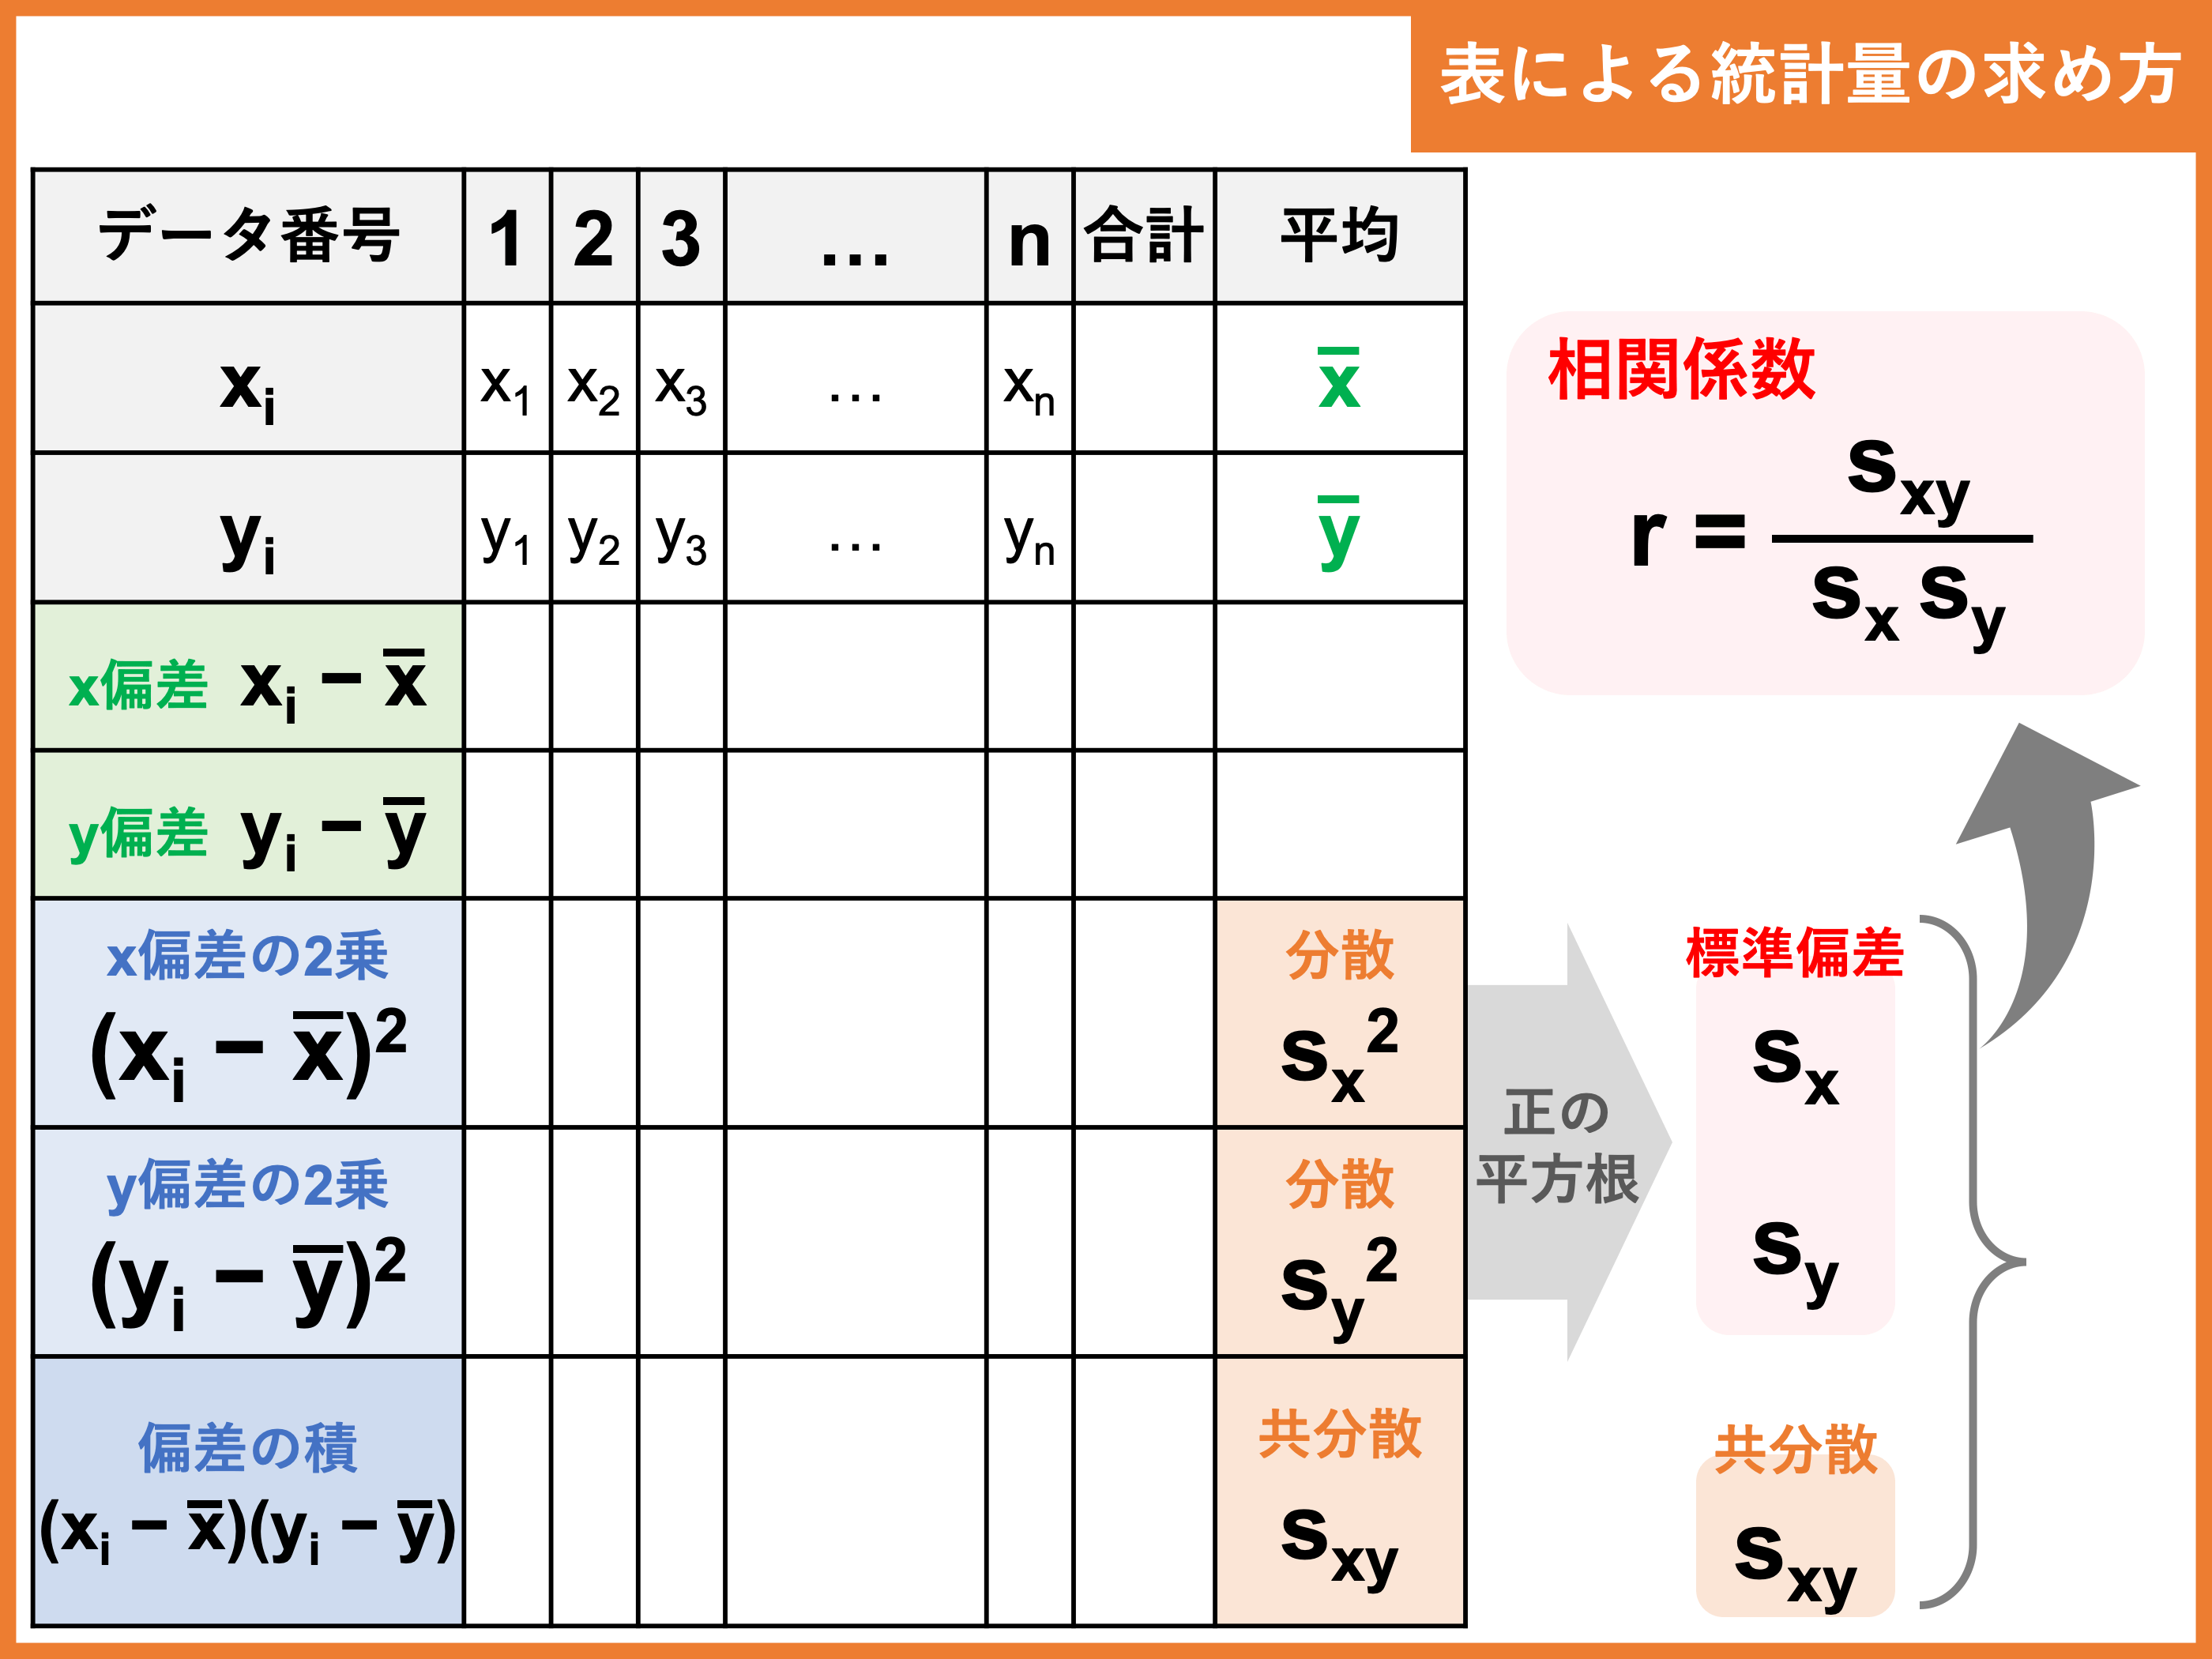
実務で頻出するデータ分析手法一覧と、現場で直ちに入力できるエクセルデータ分析関数を対比させたデータ分析チートシートを作成しました。日常業務におけるリファレンスとしてご活用ください。
| 項目・分析手法 | 主要公式・エクセル関数 | 実務上の判定基準・相場 | 編集部の見解・実務アドバイス |
|---|---|---|---|
| 記述統計(代表値) | =AVERAGE(範囲) =MEDIAN(範囲) =MODE.SNGL(範囲) | 平均値と中央値の乖離度(乖離率20%以上は歪み大) | 売上や顧客単価を見るときは必ず平均と中央値を並べるのが鉄則。平均値単体の報告は誤判断の元凶。 |
| 散布度(ばらつき) | =STDEV.S(範囲) 変動係数(CV)= 標準偏差 / 平均 | CV値 0.1以下:安定 CV値 0.3以上:ブレが大きい | 単位が異なる施策間のブレを比較する際は変動係数(CV)が極めて有効。KPIの安定度評価に推奨。 |
| 相関分析 | =CORREL(配列1, 配列2) | |r| ≥ 0.7:強い相関 0.4〜0.7:中程度 0.2以下:ほぼ相関なし | 相関関係は因果関係を意味しない。第3の潜伏変数(疑似相関)がないか必ず散布図を目視確認すること。 |
| 単回帰分析 | 傾き:=SLOPE(y範囲, x範囲) 切片:=INTERCEPT(y範囲, x範囲) 決定係数:=RSQ(y範囲, x範囲) | 決定係数($R^2$)0.5以上で実務予測に耐えうる水準 | 予算計画のシミュレーションにおいて必須。外挿(過去データの範囲外への極端な当てはめ)には要注意。 |
| 2群の差の検定(t検定) | =T.TEST(配列1, 配列2, 尾部, 種類) | p値 < 0.05(有意水準5%で差あり) | ABテストの勝敗判定に必須。サンプル数が少なすぎると検出力が落ち、多すぎると微小な差を有意と誤認する。 |
| 多群比較(一元配置分散分析) | データ分析ツール「分散分析: 一元配置」 =F.DIST.RT(F値, 自由度1, 自由度2) | F値のp値 < 0.05 | 3拠点以上の売上比較や3パターン以上のLPテストで使用。t検定の安易な反復による偽陽性を防ぐ標準手順。 |
【実態検証】利用者の生の声と現場目線で見えたリアル
データ分析ツールの普及によって、ビジネスの現場ではどのような摩擦や葛藤が起きているのでしょうか。大手IT企業、製造業DX推進部門、マーケティング代理店の担当者に対する取材や現場観察、コミュニティの議論から浮き彫りになったリアルな実態を検証します。
某大手ECモールのシニアアナリストは、現場の混乱を次のように証言しています。
「社内のBIツール刷新で、誰でもダッシュボードを作れる環境が整いました。しかし、ある若手マーケターが『キャンペーン参加者の平均購入額が1.5倍に跳ね上がった』と経営陣に報告し、大規模な追加投資が決まりかけたことがありました。慌てて原データを洗ったところ、数千人の一般ユーザーに混じって、転売業者と思われる1アカウントが数千万円分のまとめ買いをしていただけだったのです。中央値を見れば施策の効果などほぼゼロでした。数式の仕組みや外れ値の性質を知らないままツールを触ることの恐ろしさを痛感した事例です」
SNSやビジネス掲示板(知恵袋、オープンワーク等のクチコミ空間)でも、現場の悲鳴が散見されます。
「上司から『この2つの施策、どっちが良いか有意差を出して』と言われたが、そもそもサンプル数が各15件しかなく、t検定の前提を満たしていない」
「AIチャットにCSVを読み込ませて相関係数を出させたが、散布図を描いたら完全なV字型(U字型)の非線形相関で、相関係数ゼロと判定されていた。盲信していたら大惨事だった」
現場で起きている失敗の多くは、計算そのものの間違いではありません。「前提条件の無視」と「計算結果の過信」という、人間側の基礎リテラシーの欠落に起因しています。
一般に知られていない盲点とネットの誤解|「AIがあるから公式は不要」という危険な罠
ネット上の言説やビジネス書の一部には、「生成AIやノーコードツールが数式を代行してくれるため、計算公式を覚える時代は終わった」という言説が溢れています。しかし、これこそが最も危険な誤解です。
心理学における「認知的不協和の解消」や組織社会学の観点から見ると、人間は直感に反するデータや難解な数式に出くわした際、深く思考することを放棄し、耳障りの良い解釈や使い慣れたツールに依存する傾向があります。この認知的怠惰が、実務において以下のような構造的リスクを生み出します。
第1の盲点は「シンプソンのパラドックス」です。全体として正の相関が見られるデータであっても、属性別(年代別や地域別)にデータを層別化して分析すると、すべてのグループで負の相関が現れるという現象です。数式の前提となる「データの粒度」や「共変量」への洞察がなければ、AIに指示を出しても真逆の意思決定を下すことになります。
第2の盲点は「相関関係と因果関係の取り違え」です。交番の数が多い地域ほど犯罪発生件数が多いというデータがあったとしても、交番が犯罪を増やしているわけではありません。「人口密集度」という共通の原因(交絡因子)が存在するためです。回帰分析の係数が統計的に有意であったとしても、それが因果パスを表しているかはドメイン知識と実験計画法に基づかなければ判断できません。
数式の成り立ちを知る意味は、計算機になることではなく、「ツールが導き出した答えのバウンダリー(境界線)と前提条件の妥当性を監査する知性」を持つことにあります。
【プロの結論】データ分析公式を武器にできる人・慎重になるべき人の判断基準
データ分析の公式学習に対して、どのように向き合うべきか。業務特性やキャリアの志向性に応じた明確な判断基準を提示します。
■ 今すぐ公式を深く体系化すべき人(向いている条件):
・施策の効果検証を行い、経営層やクライアントに対して予算配分の根拠を説明する立場にある人
・プロダクトマネージャーやマーケターで、ABテストの勝敗基準やKPI設計を自ら策定する人
・AIや自動化ツールの出力をレビューし、誤謬やハルシネーションを検知する責任を負う管理職
■ 表面的な数式暗記に走るのを慎重に避けるべき人(おすすめできない条件):
・基礎的なエクセル操作やデータのクレンジング(欠損値処理・異常値除去)がまだ定着していない人
・数式の数学的証明にこだわりすぎて、事業課題の背景や現場のオペレーション理解を後回しにしてしまう人
・「有意差が出た=ビジネス上の成功」と短絡的に結びつけ、投資対効果(ROI)の絶対額を軽視しがちな人

【データ の 分析 公式】に関するよくある質問(FAQ)
Q1:文系出身で数学に苦手意識がありますが、どの公式から学び始めるべきですか?
A1:まずは「平均値・中央値の使い分け」と「標準偏差」の2点に絞ることを強く推奨します。エクセルで実データを動かし、極端な数字が1つ混ざるだけで平均値がどう跳ね上がるか、標準偏差がどう広がるかを体験してください。数式の手計算は不要で、「ばらつきを捉える感覚」を掴むことが実務データ分析の最優先ステップです。
Q2:エクセルの「データ分析」アドインとPythonなどのプログラミング言語、実務ではどちらを優先すべきですか?
A2:日常的なビジネス報告や数万行程度のデータであれば、エクセル関数およびデータ分析ツールで十分対応可能です。ただし、数十万行を超えるビッグデータの処理や、分析プロセスの定期自動化、高度な機械学習モデルの実装を行う段階であれば、Python(Pandas, Scikit-learn)への移行が推奨されます。どちらを使うにしても、背後で動いている統計公式のロジックは同一です。
Q3:仮説検定で「p < 0.05(有意差あり)」が出れば、その施策は必ず導入すべきですか?
A3:決してそうとは限りません。サンプルサイズが数十万規模と極端に大きい場合、売上への寄与が0.01%といった実質的に無意味な微差であっても統計的有意(p < 0.05)と判定されてしまいます。統計的有意性(差が本物か)と、ビジネス的実質性(その差がコストに見合う利益をもたらすか)は別個に評価しなければなりません。
まとめ:今後の動向と失敗しないための判断基準
データとAIがビジネスの基盤となった現代において、データ分析の公式を理解することは、複雑な事象をシンプルに捉え直すための「思考のフレームワーク」を獲得することと同義です。
重要数式は決して無機質な記号の羅列ではありません。先人たちが現実のノイズに惑わされず、真実のシグナルを見極めるために編み出した知恵の結晶です。全貌を暗記しようと気負う必要はありません。まずは自社の売上や顧客データを開き、中央値と標準偏差を算出し、相関の散布図を描いてみること。ツールの裏側にある数式の鼓動を掴むことが、データドリブンな意思決定を実現する確かな第一歩となります。 (出典: データ の 分析 公式(Yahoo!ニュース))
情報を整理して届けることが得意なWebディレクター。ユーザー視点に立った記事作成を目指しています。
